 crabster
Architecture technique
{% raw %}
Ce document décrit les choix technologiques proposés pour Crabster et le code qu'il génère. Chaque choix majeur est marqué [ADR] et peut être révisé — mais doit alors être documenté comme tel (statut, alternatives considérées, raison du changement).
1. Vue d'ensemble🔗
Crabster est composé de deux parties distinctes :
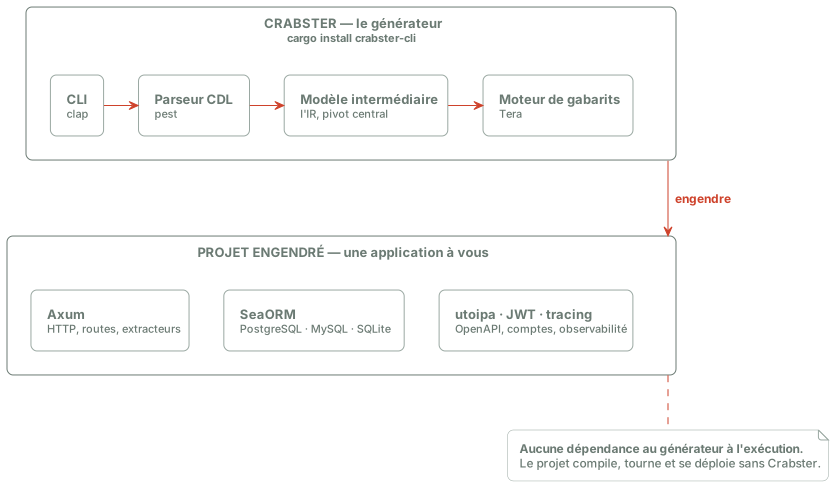
2. Le générateur (CLI)🔗
2.1 Langage et distribution — [ADR]🔗
- Rust, édition 2021 (migration 2024 envisageable une fois stabilisée dans l'écosystème des dépendances utilisées).
- CLI construite avec
clap(derive API) :crabster new— initialise un nouveau projet. Livré.crabster import-cdl <file>— génère à partir d'un fichier.cdlcomplet. Livré.crabster record <name> --field "..."— ajoute un enregistrement à un projet existant. Livré.crabster upgrade— met à jour un projet généré vers une nouvelle version des templates (le point le plus délicat, cf. §6). Prévu, Phase 11.
- Distribution :
cargo install crabster-clien V1 ; binaires précompilés (viacargo-distoucargo-binstall) dès que l'outil est stable, pour éviter d'imposer une toolchain Rust complète aux utilisateurs qui ne feraient que générer un projet Node/Java par exemple (non applicable en V1 API-only, mais pertinent si le scope s'élargit).
2.2 Parsing CDL🔗
-
Grammaire définie formellement (voir Langage CDL), parseur écrit avec
pest— [ADR tranché en Phase 3, 2026-09-05].Retenu contre
chumskypour trois raisons. La grammaire est un artefact de spécification relu en revue : un fichier.pestséparé, proche d'un BNF, sert cet objectif là où des combinateurs noyés dans du Rust ne le serviraient pas.pestfournit nativement ligne, colonne et jetons attendus, ce qu'exige la Definition of Done de la Phase 3. Enfin CDL est un langage déclaratif sans expressions : ni précédence, ni ambiguïté, donc aucun des cas difficiles où la récupération d'erreur dechumskyfait la différence.Je n'ai pas prototypé les deux comme le plan l'envisageait : le doute ne subsistait pas assez pour justifier ce coût. Si les messages d'erreur
pests'avèrent insuffisants à l'usage, le parseur est isolé derrière l'IR et reste donc remplaçable sans toucher aux templates. -
Le parseur produit un modèle intermédiaire (IR) : structures Rust représentant enregistrements, champs, types, références, validations, options de génération — indépendant de la syntaxe CDL elle-même, pour permettre d'ajouter d'autres sources de modèle plus tard (import Swagger/OpenAPI existant, réflexion sur schéma SQL existant, etc.).
2.3 Moteur de templates — [ADR]🔗
-
Tera(syntaxe proche de Jinja2/Django) plutôt queaskama: Tera accepte des templates fournis au runtime, ce qui est essentiel pour le mécanisme de blueprints (personnalisation/override sans recompiler le générateur).askamacompile les templates dans le binaire (plus rapide, plus sûr côté types) mais rendrait les blueprints externes impossibles sans redistribuer un binaire custom — incompatible avec l'objectif d'extensibilité communautaire. -
Précision issue de la Phase 2 : les templates ne viennent pas tous du disque, et c'est délibéré. Un CLI installé par
cargo installn'a aucun répertoiretemplates/à côté de lui — un moteur exclusivement disque livrerait un générateur incapable de générer. Les modules du cœur sont donc embarqués dans le binaire (include_dir!) puis passés à Tera viaadd_raw_template, tandis que les blueprints sont lus sur disque. L'objectif de l'ADR est intact — un auteur de blueprint dépose un répertoire, sans recompiler Crabster — et le binaire reste autonome.Conséquence sur la structure du dépôt : l'arborescence des templates vit sous
crates/crabster-codegen/, pas à la racine du workspace.cargo packagen'embarque que ce qui se trouve sous la racine du paquet ; un répertoire à côté n'entrerait pas dans le.crate, etinclude_dir!sur un répertoire absent est une erreur de compilation, pas une dégradation silencieuse. Uncargo install crabster-cliéchouerait donc chez chaque utilisateur. Le job CIpackageableempaquette les trois crates et rebâtit chacun depuis son propre tarball, ce qui rend ce défaut impossible à réintroduire. -
Structure des templates : un répertoire par "module" générable (
core,record,auth-jwt, …), chacun avec ses fichiers.teraet unmodule.toml(dépendances entre modules, variables de contexte attendues, ce qui allume le module, les noms qu'il occupe). La destination d'un template se déduit de son chemin en retirant.tera, plutôt que d'être déclarée — une seule source de vérité, donc aucune dérive possible. -
Un blueprint est un répertoire des mêmes modules, empilé par-dessus. La résolution se fait par template, pas par module : un blueprint qui fournit un fichier de
corehérite de tous les autres. Un template qui ne rend que du blanc n'écrit aucun fichier, et c'est ainsi qu'un blueprint en retire un. Voir Écrire un blueprint. -
Un module de blueprint déclare la version de templates contre laquelle il est écrit, et est refusé sinon. Il écrit contre des slots, des variables et des noms de fichiers qui bougent — avant la 1.0, une version mineure peut changer n'importe lequel — et sans cette déclaration l'échec arrive du fond d'un template, sans rien dire de la cause. Les modules intégrés ne la déclarent pas : ils sont livrés dans le même binaire que le numéro auquel on les comparerait.
-
Le code Rust généré est formaté automatiquement par
rustfmt(au mieux : son absence n'échoue pas la génération), et vérifiable parcargo checkviacrabster new --check. Cette vérification est optionnelle plutôt qu'automatique : elle compile tout l'arbre de dépendances, transformant une commande instantanée en commande d'une minute.
2.4 Mécanisme de blueprints (extensibilité)🔗
Le mécanisme :
- Un blueprint est un crate ou répertoire externe qui fournit des templates
.teraen remplacement ou en complément de ceux du cœur. - Résolution en couches :
blueprint utilisateur > blueprint communautaire installé > templates cœur. La surcharge est par template, pas par module : un blueprint qui fournitcore/README.md.teraremplace ce seul fichier et hérite du reste, plutôt que d'obliger son auteur à recopier et maintenir l'intégralité du module pour en changer une ligne. - Un registre de blueprints communautaires (à terme, un site simple listant les crates taggés
crabster-blueprintsur crates.io) permet la découverte. - Un template qui ne rend que du blanc n'écrit aucun fichier. C'est ainsi qu'un module dit « pas cette fois » :
src/domain/enums.rs.teras'enveloppe dans un{% if model.enums | length > 0 %}, si bien qu'un modèle sans énumération n'obtient pas un fichier que personne ne déclare ni ne lit. Aucun enregistrement côté Rust n'intervient, c'est tout l'intérêt ; le prix est qu'un fichier délibérément vide ne peut pas être généré ainsi. - Deux garde-fous s'appliquent aux blueprints, qui sont du code tiers : les liens symboliques sont ignorés plutôt que suivis — y compris un répertoire de module qui est lui-même un lien, ce qui fait alors dire au blueprint qu'il ne contient aucun module au lieu de retomber silencieusement sur les modules du cœur — et une destination sortant du projet généré est refusée.
3. Le projet généré (backend)🔗
3.1 Framework web — [ADR]🔗
- Axum, retenu plutôt qu'Actix-web ou Rocket pour :
- Intégration native avec l'écosystème
tower/tower-http(middlewares réutilisables : compression, CORS, timeout, tracing, rate-limiting). - Maintenu par l'équipe Tokio, adoption large et croissante, bonne compatibilité avec
sqlx/sea-orm. - Pas de macros magiques à la Rocket ; types explicites, plus facile à générer et à faire relire/comprendre par un développeur découvrant le code.
- Intégration native avec l'écosystème
- Alternative documentée mais non retenue en V1 : Actix-web (performances comparables, écosystème mature, mais modèle d'acteur et macros moins alignées avec le style "code généré lisible").
3.2 ORM et accès aux données — [ADR]🔗
- SeaORM, retenu plutôt que Diesel pour :
- API asynchrone native (cohérente avec Axum/Tokio), alors que Diesel est synchrone par défaut (nécessite un pool bloquant +
spawn_blocking, une couche de complexité supplémentaire à générer et expliquer). - Modèle entité/relation familier à quiconque a pratiqué un ORM (repositories, relations
has_many/belongs_to, chargement configurable). - Migrations intégrées (
sea-orm-migration), génération de code depuis un schéma existant (sea-orm-cli generate entity) utile pour le futur mode "reverse engineering" (cf. Phase 13). - Diesel reste documenté comme blueprint alternatif possible pour les équipes qui préfèrent la vérification de requêtes à la compilation.
- API asynchrone native (cohérente avec Axum/Tokio), alors que Diesel est synchrone par défaut (nécessite un pool bloquant +
- Support base de données V1 : PostgreSQL (référence), MySQL (écrit
mysql; MariaDB est compatible au niveau du protocole), SQLite (dev/tests). NoSQL (MongoDB) documenté comme extension future hors SeaORM (driver dédié).
3.3 Migrations🔗
sea-orm-migration, fichiers de migration générés et versionnés dans le projet soussrc/migration/, comme un module Rust du crate — un fichier par enregistrement, numérotés dans l'ordre où ils doivent s'appliquer, natifs Rust et compilés : pas de XML ni de YAML séparé du code.
3.4 Authentification et sécurité — [ADR]🔗
- JWT stateless via
jsonwebtoken, généré par le moduleauth-jwtqu'activeservice { auth jwt }.rust_cryptoplutôt qu'aws_lc_rs, pour qu'un projet généré n'ait besoin d'aucune chaîne C pour se construire — et l'un des deux est obligatoire : sans, le crate panique à la première signature, à l'exécution. - Hachage de mots de passe :
argon2, aux paramètres recommandés par le crate plutôt qu'épinglés — l'encodage stocke ceux avec lesquels il a été fait, donc un hachage écrit sous les anciens se vérifie encore après une montée de version. Un login qui ne trouve aucun compte hache quand même contre un leurre, pour qu'une adresse inconnue ne soit pas mesurablement plus rapide qu'un mauvais mot de passe. - Autorisation : un extracteur
Authenticated, etclaims.require_role("ADMIN"). Pas une macro, ce que cette section promettait : une méthode se lit comme le code autour, apparaît dans une trace d'appels, et n'a pas besoin qu'on explique ce en quoi elle se développe. Nommer l'extracteur dans un handler est ce qui protège une route — donc une route ne peut pas être annoncée protégée sans l'être. - Les rôles viennent du token, et sont relus depuis le compte à chaque rafraîchissement. C'est ce que coûte le stateless : un rôle retiré prend effet à l'expiration du token d'accès — quinze minutes — et non au moment où il est retiré. Un token ne peut pas être révoqué du tout, d'où une durée d'accès courte et une durée de rafraîchissement longue.
- La clé de signature est refusée deux fois : le placeholder livré par
.env.exampleest refusé hors du profildev, et une clé de moins de 32 octets est refusée dans tous les profils. Les deux au démarrage, pour qu'un service incapable de signer quoi que ce soit n'aille jamais jusqu'à être déclaré sain. - Les limites HTTP appartiennent à
core, pas au module d'authentification : timeout de requête répondu en408, limite de concurrence, limite de taille de corps,nosniffsur chaque réponse, et un CORS fermé par défaut sans moyen de dire « n'importe qui » — un joker sur une API qui lit un token est un joker sur ce token. - Aucune limitation de débit n'est générée, délibérément. Un limiteur dans le processus compte le trafic d'une seule réplique, donc le nombre configuré veut dire autre chose à chaque changement d'échelle, et ce qu'il vaut la peine de limiter est en général par appelant — une identité que cette couche n'a pas. Cela appartient à ce qui termine TLS devant le service.
- OAuth2/OIDC : reporté après la V1, via le crate
oauth2— documenté comme une phase ultérieure plutôt que d'enfler le périmètre V1. - Authentification par session : pas une priorité, le JWT stateless couvrant le cas API-only le plus courant.
3.5 Documentation API — [ADR]🔗
utoipa+utoipa-swagger-ui: génère le document OpenAPI 3.1 directement depuis des attributs posés sur les handlers et les DTO générés (approche « code-first », cohérente avec le style Rust, plutôt qu'un fichier OpenAPI séparé à maintenir à la main). Servi sur/api-docs/openapi.json, avec une console sur/swagger-ui.- Les assets de Swagger UI sont embarqués, pas téléchargés. Par défaut
utoipa-swagger-uiles récupère dans son script de build, ce qui rendrait un projet généré inconstructible sans réseau et tireraitreqwestdans son arbre de build ; la featurevendoredles compile dans le binaire, pour environ deux mégaoctets. - Chaque opération porte un
operation_idexplicite. Un générateur produit unlistdans le module de chaque enregistrement, et une spécification ne peut pas nommer deux opérations pareil — l'identifiant est donc construit depuis le nom de l'enregistrement plutôt que laissé au nom de la fonction. - Les types aliasés par SeaORM sont annotés explicitement. utoipa lit un type par le nom sous lequel il est écrit, et
Date,Decimal,UuidetDateTimeUtcsont des alias de SeaORM — des noms qu'il n'a jamais rencontrés. La correspondance vers un type et un format de schéma vit dansview.rs, à côté du type Rust et du type de colonne, qui sont les deux autres moitiés de la même décision. - Un
.spectral.yamlest généré avec le projet, et le document le passe sans rien à aucune sévérité. Une règle y est désactivée,info-contact: qui répond d'une API se décide là où elle tourne, pas là où elle a été générée.
3.6 Validation🔗
validatorsur les DTOs générés, règles dérivées automatiquement des contraintes CDL (required,minlength,maxlength,pattern,min/max).
3.7 Configuration🔗
config+ variables d'environnement, profils nommés parAPP_PROFILE(config/{profil}.toml). Deux sont générés :prod, qui est ce qu'obtient unAPP_PROFILEabsent — un déploiement n'a pas de.env, et un serveur qui se lierait par défaut à la boucle locale serait un conteneur que personne ne peut joindre — etdev, que.env.examplesélectionne. Unconfig/test.tomln'est pas généré : les tests générés construisent l'application en processus sur un SQLite en mémoire et ne lisent jamaisconfig/. N'importe quelconfig/{nom}.tomldéposé là est ramassé.- Secrets jamais committés :
.env.examplegénéré, intégration documentée avec des gestionnaires de secrets externes (Vault, AWS Secrets Manager…) en tant que guide, pas en tant que dépendance imposée.
3.8 Erreurs🔗
- Type d'erreur applicatif unifié via
thiserrorpour les erreurs internes, converti en réponse HTTP structurée par son implémentation d'IntoResponse. - Toute défaillance répond en problem details RFC 9457 — la révision de la RFC 7807 — servi en
application/problem+json, y compris celles qu'Axum rejetterait lui-même en texte brut ou avec un corps vide. typeest ce sur quoi un client branche, et le champ que le statut ne peut pas remplacer : un409pour une valeur unique déjà prise et un409pour une référence qui ne tient pas sont deux problèmes différents sous un même code. C'est une URI relative que le projet sert :GET /problems/unique-conflictexplique ce genre-là, etGET /problemsles liste tous. La RFC 9457 demande qu'une URI de type qui est un localisateur ait de la documentation derrière elle ; ici elle en a — plutôt qu'about:blank, qui prétendrait qu'il n'y a rien à dire.- Un corps refusé répond 422, pas 400, et c'est la Definition of Done de la feuille de route qui a été corrigée, pas le code : la RFC 9110 définit le 422 comme une requête bien formée et sémantiquement fausse, Axum répond déjà 422 une couche plus haut pour un corps qui ne correspond pas à la forme attendue, et fondre les deux dans un 400 rendrait « je n'ai pas pu lire ceci » indiscernable de « je l'ai lu et je n'en veux pas ».
3.9 Tests🔗
- Tests unitaires standards Rust (
#[cfg(test)]), qui passent par le routeur complet plutôt que d'appeler les handlers : le routage, les extracteurs, les couches et le format d'erreur sont précisément ce qu'un test appelant un handler directement n'exerce pas. - Contre la base que le projet vise, via
testcontainers:src/testing.rsdémarre un conteneur pour l'ensemble du binaire de test et crée une base par test. SQLite n'a besoin ni de l'un ni de l'autre, étant un fichier.TEST_DATABASE_URLcourt-circuite le conteneur pour un job CI qui fait déjà tourner un serveur. - Contre le moteur de recherche qu'il vise, de la même façon :
src/search/testing.rsdémarre un Meilisearch pour l'ensemble du binaire de test et donne à chaque état des noms d'index que personne d'autre n'utilise.TEST_SEARCH_ADDRESScourt-circuite le conteneur. Une suite qui attendrait qu'on lui ait démarré un moteur à la main passerait sur une machine et échouerait sur toutes les autres, ce qui n'est pas une suite. - Et il les reprend. Une poignée rangée dans un
staticn'est jamais détruite, donc rien ne donne àtestcontainersl'occasion de retirer ce qu'il a démarré. Chaque harnais lance un faucheur qui tient le bout lecteur d'un tube où la suite n'écrit jamais : quand la course s'achève, de quelque manière que ce soit, le noyau ferme le tube, le faucheur se réveille et supprime le conteneur. Un destructeur aurait manqué leSIGKILL; celui-ci ne le manque pas. - Une base par test, pas une partagée. Ces tests comptent des lignes ; en partager une les ferait dépendre de l'ordre d'exécution.
- Tous les enregistrements sont couverts, y compris les deux formes autrefois écartées. Une référence obligatoire est créée par l'endpoint du parent, et la valeur d'exemple d'un
@matchesest engendrée depuis le motif puis vérifiée contre lui — une table de motifs connus couvrirait les trois que tout le monde écrit et laisserait le reste du langage sans tests. - Génération d'un jeu de tests CRUD complet par enregistrement (create/read/update/delete/list/filter/pagination).
3.10 Observabilité🔗
tracing+tracing-subscriberpour les logs structurés — lisibles dans le profildev, JSON partout ailleurs. L'export OpenTelemetry reste optionnel et n'est pas généré : ce vers quoi un service envoie ses traces se décide là où il est déployé, pas dans son code. Le point d'accroche est en place (init_tracingdanssrc/observability.rs) et le README généré décrit le branchement.- Identifiant de corrélation. Chaque requête porte un
x-request-id, forgé si elle arrive sans, inscrit dans chaque ligne de journal de cette requête, et renvoyé sur la réponse. - Endpoint de métriques Prometheus via
axum-prometheus: compteur, histogramme de latence et requêtes en vol, étiquetés par la route matchée —/api/products/{id}, jamais/api/products/1— pour que le nombre de séries soit borné par la taille du projet et non par son trafic. Les sondes de santé et/metricslui-même ne sont pas comptés. - Trois endpoints de santé.
/health/livene joint rien : une politique de redémarrage le lit, et redémarrer un processus sain parce qu'une base est tombée transforme une panne en deux./health/readyjoint tout ce dont le service dépend et répond503en nommant ce qui manque ; un répartiteur de charge le lit./healthreste, et répond la vivacité, sous le nom qu'il avait avant que les deux soient séparés. - Le readiness est composé, pas codé en dur.
src/health.rsappartient àcore, qui ne connaît pas de base de données ; la sonde qui en interroge une est contribuée par le modulerecordà travers les slots de ce fichier. Un projet sans modèle de domaine garde donc l'endpoint et n'a rien à lister — et un module qui apportera plus tard sa propre dépendance ajoutera sa sonde sans quecorechange.
3.11 Conteneurisation et déploiement🔗
Dockerfilemulti-étages généré, avec cache de dépendances viacargo-chef—cargoreconstruit tout dès qu'un fichier change, donc sans lui une édition d'une ligne recompile l'arbre entier. L'étage final estgcr.io/distroless/cc: le binaire, sonconfig/, rien d'autre, ennonroot.ccplutôt questatic, la compilation se liant à la glibc.- L'image de base est épinglée sur le MSRV du projet, qui vit dans le manifeste de chaque module et atteint les templates en une seule variable. Trois fichiers nomment ce numéro — le manifeste, le
Dockerfileet la CI que suggère le README — et trois copies, ce sont trois occasions d'en relever deux ; un test tient les deux premières ensemble. docker-compose.ymlgénéré pour le développement local. La base de données est là depuis la Phase 5, sur exactement l'hôte, le port, l'utilisateur, le mot de passe et le nom de base que.env.exampledésigne — donccp .env.example .env && docker compose up -d --wait && cargo runne demande rien à remplir. Rien n'est généré pour SQLite, qui est un fichier et n'a pas de serveur à démarrer. L'application s'y ajoute en Phase 8, avec leDockerfilequ'elle a besoin de construire. Un service supplémentaire se met dans undocker-compose.override.yml, que Compose fusionne seul et que la régénération ne touche jamais.- Manifests Kubernetes de base générés en option (Deployment, Service, ConfigMap) — priorité basse, Phase 11.
3.12 CI/CD🔗
- Pipeline GitHub Actions généré :
cargo fmt --check,cargo clippy -- -D warnings,cargo testcontre la base que le projet vise,rustsec/audit-check, et une construction de l'image. Aucun secret, aucun réglage de dépôt : il passe sur un dépôt qui vient d'être créé. - L'image est construite et non poussée. Où une image appartient est une décision d'infrastructure, et pousser demande un registre et une identité qu'un générateur ne peut pas inventer ; le workflow dit en commentaire quoi ajouter.
- GitLab CI est documenté plutôt que généré — on utilise l'une ou l'autre, et générer les deux laisse un fichier mort dans chaque projet. Le README généré porte le pipeline équivalent en entier.
4. Modèle intermédiaire (IR) — pivot central🔗
L'IR est le contrat stable entre "parser CDL" et "moteur de génération". Il doit rester agnostique de la syntaxe CDL pour permettre, à terme, d'autres sources d'entrée (import d'un schéma SQL existant, import OpenAPI). Esquisse de structure (détaillée en Phase 3) :
struct DomainModel {
    records: Vec<Record>,
    enums: Vec<Enumeration>,
    service: Option<Service>,   // nom, base de données, port
}

struct Record {
    name: String,
    fields: Vec<Field>,         // un champ peut être une référence
    filterable: bool,
}

struct Field {
    name: String,
    kind: FieldType,            // Scalar | Enum(nom) | Reference(nom)
    optional: bool,             // obligatoire par défaut
    unique: bool,
    length: Option<Bounds>,
    range: Option<Bounds>,
    matches: Option<String>,
}
Il n'y a pas de type « relation » : une référence est un champ, et le côté qui la déclare est celui qui porte la clé étrangère. Cette absence supprime tout le code qui aurait servi à déterminer de quel côté placer la colonne.
5. Structure du dépôt Crabster (monorepo proposé)🔗
crabster/
├── crates/
│   ├── crabster-cli/       # binaire, sous-commandes clap
│   ├── crabster-cdl/       # parseur CDL + IR
│   ├── crabster-codegen/   # moteur Tera + orchestration des modules
│   │   └── templates/      # templates du code généré — sous le crate, pas à la
│   │       ├── core/       #   racine : `cargo package` n'embarque que ce qui est
│   │       ├── record/     #   sous la racine du paquet, et `include_dir!` sur un
│   │       ├── auth-jwt/   #   répertoire absent est une erreur de compilation
│   │       ├── db-postgres/ db-mysql/ db-sqlite/
│   │       ├── docker/
│   │       └── ci-github-actions/
│   └── crabster-shared/    # utilitaires partagés (si nécessaire au runtime généré)
├── examples/               # modèles CDL de référence, générés et exercés en CI
└── docs/
6. Le défi de la mise à jour incrémentale ("upgrade")🔗
C'est le point le plus délicat du domaine : fusionner du code généré que l'utilisateur a modifié. Approche envisagée :
-
V1 : génération "one-shot" pour un nouveau projet, plus l'ajout simple d'un enregistrement (
crabster record). L'ajout ne fusionne rien : chaque fichier généré a été estampillé au moment où il a été écrit, et un fichier qui correspond encore à son empreinte est à nous et peut bouger. Un fichier qui n'y correspond plus a été modifié par son propriétaire : la commande s'arrête en le nommant, sans rien écrire, à moins de--force.Le projet conserve donc, dans
.crabster/:model.cdl, le.cdld'origine tel quel — commentaires compris ;project.toml, ce que la ligne de commande a décidé et qu'aucun.cdln'exprime (--database,--port, le nom) ; etfiles.toml, une empreinte par fichier généré. L'alternative évidente — rendre à nouveau l'ancien modèle et comparer — paraît plus économique et ne marche pas : le rendu passe parrustfmt, un binaire externe trouvé dans lePATH, non épinglé, et sensible à n'importe quelrustfmt.tomldu répertoire courant. Une toolchain installée sansrustfmtfaisait passer dix-huit fichiers intacts pour des fichiers modifiés à la main. Une empreinte prise à l'écriture ne dépend d'aucun des deux. Il conserve aussisnapshot/, une copie de chaque fichier généré tel qu'il a été écrit : cette copie est l'ancêtre commun de la fusion 3-voies quecrabster upgradeopère sur un fichier édité par son propriétaire, et il n'y a pas d'autre façon d'en avoir un — ce que le générateur a produit un jour n'est pas reconstituable après coup, ses templates étant compilés dans le binaire qui l'a écrit. Cela coûte au dépôt une copie committée de son code généré. Le répertoire se versionne avec le projet, et c'est le.crabster/que décrit l'ADR-0002.Trois garde-fous s'appliquent. Un projet dont les fichiers ne correspondent plus à ce qu'il enregistre — un fichier généré supprimé, un modèle édité à la main — est refusé, sinon les migrations déjà appliquées seraient renumérotées et des modules orphelins resteraient derrière. Un enregistrement ne peut qu'être ajouté à la fin, ce qui laisse intacts les noms de migration existants. Et un projet généré par une autre version de Crabster est refusé aussi : rendre son modèle à nouveau ne dit ce que les fichiers contenaient que tant que les templates n'ont pas bougé, sans quoi le projet entier paraîtrait modifié à la main. Franchir une version, c'est
crabster upgrade, en Phase 11. Pas de fusion intelligente de fichiers déjà modifiés à la main dans un cas comme dans l'autre : Phase 11 également. -
Phase ultérieure : fichiers générés marqués par des commentaires de zones protégées (des marqueurs de zone réservée), permettant une fusion assistée (trois-voies, à la
git merge) lors des mises à jour de version des templates.
7. Alternatives explicitement écartées (et pourquoi)🔗
| Choix retenu | Alternative écartée | Raison |
|---|---|---|
| Axum | Rocket | Macros trop "magiques" pour du code généré à relire/modifier facilement |
| Axum | Actix-web | Modèle acteur ajoute une complexité conceptuelle non nécessaire ; Axum/tower suffit |
| SeaORM | Diesel | API async native, modèle entité/relation familier |
| SeaORM | SQLx brut | SQLx reste une option bas niveau envisageable pour un blueprint "requêtes SQL à la main", mais SeaORM est plus proche de l'expérience "entités" attendue par défaut |
| Tera | Askama | Templates chargés au runtime indispensable pour les blueprints externes |
| JWT stateless | Session | Cas d'usage API-only prioritaire ; session différée |
| {% endraw %} |